Generative AI
Diffusion Models
Quantisation
Feature Caching
Benchmarking
A controlled benchmarking study of methods for reducing SDXL image-generation latency and memory use while measuring the effect on output quality.
Experiment
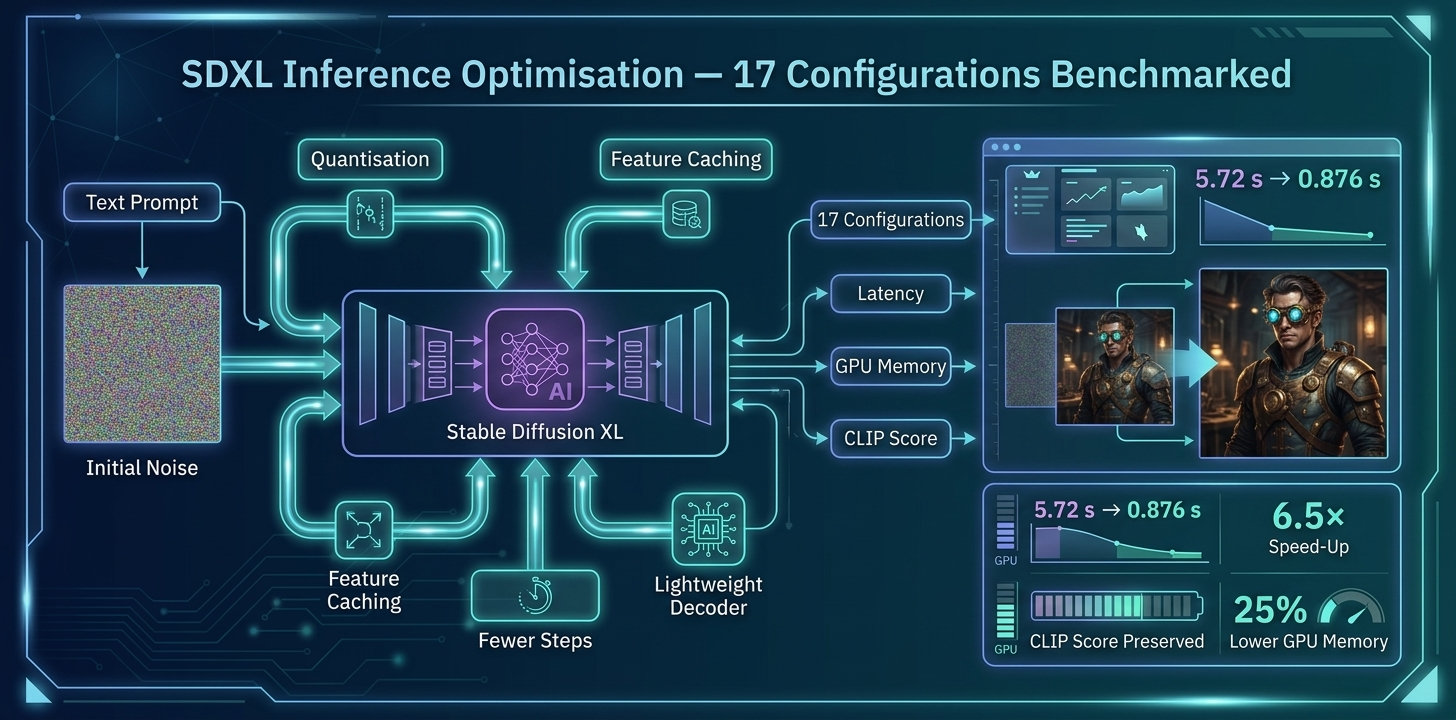
- Compared 17 optimisation configurations
- Measured latency, GPU memory use and CLIP score
- Evaluated quantisation, feature caching, fewer denoising steps, compilation and a lightweight decoder
- Tested individual methods and combined configurations
Results
- Reduced latency from 5.72 seconds to 0.876 seconds
- Achieved a maximum 6.5× speed-up while preserving CLIP score
- Identified a balanced configuration with a 4.5× speed-up and 25% lower GPU memory use
Tech Stack
Python, PyTorch, Stable Diffusion XL, Diffusers, quantisation, feature caching, model compilation and CLIP-based evaluation.